/home/by-natures/dev*

データ界隈で働くエンジニアとしての技術的なメモと、たまに普通の日記。

BigQuery の Iceberg マネージドテーブルを試してみた

stable株式会社さんが主催されている、データエンジニアリングもくもく会に参加しました。

stable.connpass.com

どんなテーマで勉強しようかと思ったのですが、Iceberg について業務で触れることが少ないので、Iceberg + BigQuery の機能について調べることにしました。BigQuery の Iceberg マネージドテーブル(BigLake Iceberg tables in BigQuery) を使い、既存の BigQuery テーブルを Iceberg 形式で GCS に出力して DuckDB から読む、という検証をしました。

「BigQuery で書き込みつつ、DuckDB や Spark などの外部エンジンからも読める」という触れ込みの機能ですが、実際に触ってみると、通常の Iceberg とはスナップショットの扱いが大きく異なることがわかりました。先に結論をまとめます:

  • Iceberg マネージドテーブルの書き込みは BigQuery 専用
  • EXPORT TABLE METADATA を実行するまで、外部エンジンからは一切読めない。GCS 上にあるのはプレースホルダだけで、Iceberg 仕様のメタデータですらない
  • EXPORT で書き出されるメタデータは常に「現在のスナップショット1件のみ」。過去のスナップショットへの参照を持たないため、外部エンジンからのタイムトラベルは原理的にできない(当然ですが、BigQuery 内部でのタイムトラベルは可能)

Apache Iceberg とは

Apache Iceberg は、大規模な分析用データセットのためのオープンなテーブルフォーマットです。GCS や S3 上の Parquet ファイル群に「テーブル」としての一貫性を与えるメタデータレイヤーで、主な特徴は以下です。

  • ACID なコミット: 書き込みはスナップショット単位でアトミックに反映される
  • タイムトラベル: 過去のスナップショット時点のデータを再現できる
  • スキーマ進化: カラム追加・リネーム・型の拡張をデータ書き換えなしで行える
  • 隠しパーティショニング: month(order_date) のような変換パーティションを定義でき、クエリ側はパーティション列を意識しなくてよい
  • マルチエンジン: Spark、Trino、Flink、DuckDB など、Iceberg を理解するエンジンならどれでも同じテーブルを読める

特定のクエリエンジンにデータを閉じ込めない、というのが最大の価値だと理解しています。

Iceberg のファイル構造

Iceberg テーブルの実体は、階層化されたメタデータとデータファイルです。今回の検証でもこの構造がそのまま GCS 上に現れるので、先に整理しておきます。
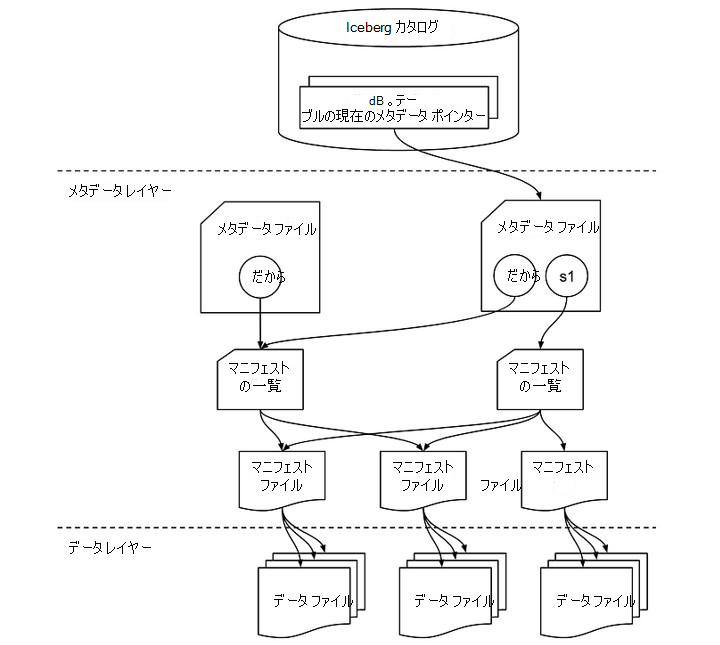
Iceberg ファイル構造

統合カタログの Iceberg Open Table Format (プレビュー) のデータ品質 | Microsoft Learn

レイヤー 役割
Catalog 「このテーブルの最新 metadata JSON はどれか」というポインタを管理し、書き込み時のアトミックな差し替えを保証する
Metadata File テーブル定義の中心。スキーマ、パーティション仕様、スナップショット一覧、現在のスナップショット ID を持つ
Manifest List 1スナップショット = 1 manifest list。そのスナップショットを構成する manifest の一覧
Manifest File データファイルへのインデックス。ファイルパスに加えカラムごとの min/max 統計を持ち、クエリエンジンはこれで不要なファイルを読み飛ばす(プルーニング)
Data File 実データ(Parquet など)

スナップショットの構造(本来の Iceberg)

  • データを変更するコミット(append / overwrite / delete / compaction)が成功するたびに、新しいスナップショットが1つ作られる
  • 新しいスナップショットは parent-snapshot-id で直前のスナップショットを指し、metadata JSON の snapshots 配列に過去のスナップショットも蓄積されていく
  • スナップショットはデータのコピーではなく manifest へのポインタ集合。変更のなかったデータファイルはスナップショット間で共有されるため、非常に軽量
  • この履歴の連鎖がタイムトラベル(snapshot-id や時刻を指定した過去データの参照)を支えている
snapshots: [
  { snapshot-id: 111, parent: null, operation: append },
  { snapshot-id: 222, parent: 111,  operation: append },
  { snapshot-id: 333, parent: 222,  operation: delete }   ← current
]

BigQuery における Iceberg テーブルは2種類

検証を始める前にまず引っかかったのがここでした。BigQuery で「Iceberg」と名の付くテーブルには2種類あり、性質がまったく違います。

Iceberg 外部テーブル Iceberg マネージドテーブル
正式名称 BigLake external tables for Apache Iceberg BigLake Iceberg tables in BigQuery
作成方法 CREATE EXTERNAL TABLE で既存の Iceberg メタデータを参照 CREATE TABLE ... OPTIONS(table_format='ICEBERG')
書き込み 読み取り専用 BigQuery から INSERT / UPDATE / DELETE 可能
ユースケース Spark 等が管理する既存 Iceberg テーブルを BigQuery から読む BigQuery で書き込み・管理し、外部エンジンにも公開する

当初は「Iceberg 形式の外部テーブルを作ってロードする」つもりでいたのですが、外部テーブルは読み取り専用で INSERT できません。「BigQuery のテーブルを Iceberg 形式で GCS に出力する」という今回の目的には、書き込みができるマネージドテーブルを利用しました。

検証

環境

※ プロジェクト名・テーブル名などはすべて架空のものに置き換えています。

  • ソース: my-project-prod.sales_mart.order_item(通常の BigQuery テーブル、約3,300万行・論理サイズ約19.3GB・70カラム)
  • 作成先: my-project-dev.sandbox.order_item(Iceberg マネージドテーブル)
  • 出力先バケット: gs://my-iceberg-bucket
  • 読み手: DuckDB v1.5.5(iceberg extension)

事前の注意点として、データセット・バケット・接続の3つのロケーションを一致させる必要があります(今回はすべて asia-northeast1 に揃えました)。

Step 1. Cloud Resource 接続の作成

BigQuery が GCS に書き込むための「接続」を作成します。

bq mk --connection \
  --project_id=my-project-dev \
  --location=asia-northeast1 \
  --connection_type=CLOUD_RESOURCE \
  iceberg-conn

接続を作るとサービスアカウント(bqcx-<プロジェクト番号>-xxxx@gcp-sa-bigquery-condel.iam.gserviceaccount.com 形式)が発行されるので、バケットへの権限を付与します。

gcloud storage buckets add-iam-policy-binding gs://my-iceberg-bucket \
  --member="serviceAccount:bqcx-xxxx@gcp-sa-bigquery-condel.iam.gserviceaccount.com" \
  --role="roles/storage.objectAdmin"

Step 2. Iceberg マネージドテーブルの作成

通常の CREATE TABLE に、接続と Iceberg 用オプションを付けるだけです。

CREATE TABLE `my-project-dev.sandbox.order_item` (
  order_item_code STRING,
  order_code STRING,
  ...
)
WITH CONNECTION `my-project-dev.asia-northeast1.iceberg-conn`
OPTIONS (
  file_format = 'PARQUET',
  table_format = 'ICEBERG',
  storage_uri = 'gs://my-iceberg-bucket/order_item'
);

Step 3. データのロード

INSERT INTO `my-project-dev.sandbox.order_item`
SELECT * FROM `my-project-prod.sales_mart.order_item`;

約3,300万行のロードは数秒で完了しました。GCS を見ると Parquet ファイルが 500 個生成されており、合計サイズは約3.6GB。BigQuery 上の論理サイズ 19.3GB がここまで小さくなっていました。

gs://my-iceberg-bucket/order_item/data/....parquet   × 500
gs://my-iceberg-bucket/order_item/metadata/v0.metadata.json

Step 4. この時点で DuckDB から読んでみる → 読めない

metadata フォルダには v0.metadata.json があるので、一見読めそうです。DuckDB で試してみると:

Invalid Input Error: TableMetadata required property 'format-version' is missing

エラーになりました。v0.metadata.json の中身を見てみると:

{"properties":{"bigquery-table-id":"my-project-dev.sandbox.order_item"},"current-snapshot-id":-1}

Iceberg 仕様のメタデータですらなく、単なるプレースホルダでした。つまり EXPORT 前の状態は「古いデータが見える」のではなく、GCS に 3.6GB の Parquet があっても、それをテーブルとして解釈する手がかりが一切ない状態です。メタデータの正体は BigQuery 内部にあり、GCS 側はまだ空箱、ということのようです。

Step 5. EXPORT TABLE METADATA を実行

外部エンジンに公開するには、明示的にメタデータをエクスポートする必要があります。

EXPORT TABLE METADATA FROM `my-project-dev.sandbox.order_item`;

これで metadata フォルダに本物の Iceberg メタデータが生成されました。

metadata/
├── v0.metadata.json                        # プレースホルダ(残る)
├── v1784942316.metadata.json               # 本物のメタデータ (format-version: 2)
├── xxxx-f-manifest-list-....avro           # manifest list
├── xxxx-f-....avro                         # manifest
└── version-hint.text                       # 最新バージョン番号を指すヒントファイル

version-hint.text は「最新の metadata JSON はどれか」を外部エンジンに教えるためのファイルで、カタログを使わないファイルシステムベースの運用(旧 HadoopCatalog 方式)の慣習です。

ちなみにこの EXPORT、デフォルトでは毎回手動です。自動化したい場合は

  • (a) scheduled query で定期実行する
  • (b) Google に申請してテーブル変更ごとの auto-refresh を有効にしてもらう
  • (c) dbt の post-hook などロードパイプラインの最終ステップに組み込む

という選択肢があります

Step 6. EXPORT 後、DuckDB から読む

今回はテーブルフォルダごとローカルにコピーして読みました(DuckDB から GCS を直接読むには HMAC キーという別のクレデンシャルが必要なため)。

INSTALL iceberg; LOAD iceberg;
SELECT count(*) FROM iceberg_scan('order_item', allow_moved_paths=true);
-- 33,158,251 行 (BigQuery と完全一致)

集計クエリも問題なく動き、NUMERIC(decimal)や DATE / DATETIME 型もそのまま扱えました。

ここで少しハマったのが allow_moved_paths=true です。これを付けないと:

IO Error: ... HTTP GET to 'https://storage.googleapis.com/my-iceberg-bucket/...'

と、GCS へ直接アクセスしようとして失敗します。metadata JSON 内のファイルパスは gs:// の絶対パスで記録されているため、ローカルコピーで読むには「絶対パスを無視してテーブルルートからの相対位置で解決する」このオプションが必要でした。

Step 7. もう一度 EXPORT してみる → スナップショット履歴が繋がらない

データを変更せずにもう一度 EXPORT TABLE METADATA を実行し、新旧の metadata JSON を比較してみました。

1回目 2回目
snapshots 配列 1件のみ 1件のみ
snapshot-log 自分自身の1件のみ 自分自身の1件のみ
過去スナップショットへの参照 なし なし(1回目の存在に触れていない)

データを更新していないのに、2回目の EXPORT は新しいスナップショット ID を発行し、しかも1回目のスナップショットを履歴として引き継ぎません。本来の Iceberg なら「書き込みがなければ新しいスナップショットは生まれない」「履歴は snapshots 配列に蓄積される」ので、どちらも通常とは異なる挙動です。

検証結果のまとめ

観点 通常の Iceberg BigQuery マネージドテーブル
スナップショット作成 書き込みコミットごとに自動 内部では管理されるが、GCS へは EXPORT 時に合成
スナップショット履歴 snapshots 配列に蓄積、parent で連鎖 常に最新1件のみ、親リンクなし
外部エンジンからのタイムトラベル 可能 不可能
BigQuery 内でのタイムトラベル — 可能(内部メタデータ、デフォルト7日)
書き込み 任意の対応エンジン(カタログが調停) BigQuery のみ

公式ドキュメントでも、タイムトラベルは "Time travel for historical data access in BigQuery" と BigQuery 内に限定して記載されており、外部エンジン向けには「最新スナップショットへの直接クエリアクセス」だけが謳われています。さらに、タイムトラベル期間(デフォルト7日)を過ぎた古いデータファイルは GCS 上からガベージコレクションされるため、「古い metadata JSON を手元に保存しておいて過去を読む」という運用も成立しません。

良かった点・気になった点

良かった点

  • 既存の BigQuery テーブルからの移行は「接続作成 → CREATE TABLE → INSERT」だけで、拍子抜けするほど簡単でした
  • 19.3GB → 3.6GB という Parquet 圧縮の効果が体感できた
  • BigQuery 課金なしで外部エンジン(Spark / DuckDB / Databricks 等)に大量データを読ませたい、という用途にはよく合いそうです

気になった点

  • EXPORT を忘れると外部からは何も見えないのに、GCS 上には一見それらしいファイルが並ぶので気づきにくい
  • スナップショット履歴が外部に公開されないため、外部エンジンからのタイムトラベルなど「Iceberg 本来のフル機能」を期待すると肩透かしを食う
  • 外部エンジンからの書き込みもできないため、あくまで「BigQuery が主、外部エンジンは読み取り専用の従」という関係になる

総じて、BigQuery の Iceberg マネージドテーブルは「書き込みと管理は BigQuery が握り、外部エンジンには最新状態の静止画だけを公開する」という設計だとわかりました。「Iceberg フォーマットで保存されている」ことと「Iceberg のフル機能が使える」ことは別物、というのが今回一番の学びです。

Iceberg 本来のスナップショット履歴やスキーマ進化はまだ体験できていないので、次回は PyIceberg + ローカルカタログで自分がフルコントロールできるテーブルを作り、タイムトラベルやスキーマ進化を試したいと思います。

参考

CA DATA NIGHT #10 で Databricks 利用事例を発表しました

先日、CA DATA NIGHT の第10回目で発表をさせていただきました。

テーマは Databricks で、CA グループで Databricks を使っている事例を共有するものです。社内や関連グループの方が多かったですが、社外の方も多く参加されていました。

イベントページ

cyberagent.connpass.com

発表資料

「AWS PrivateLink × SCIM で実現する セキュアで運⽤負荷の低い Databricks 基盤の構築」というタイトルで発表させていただきました:

スライド作成にマークダウン形式でPDFを作成できる Marp という VSCode のプラグインを利用しました。その使用感などは次のブログで共有しましたので、併せてご覧ください:

bynatures.hatenadiary.jp

イベントの感想

CA DATA NIGHT は、CA グループでの事例を中心に、データに関するトピックを共有する勉強会です。今回はオンラインなしのオフライン(現地のみ、配信なし)という形式で、1年ぶりに外部イベントに登壇させていただきました。

私は業務委託という形で今回発表したプロジェクトには携わっています。数年前まで CA グループにいましたが、仕事だけでなく発表の機会もいただけるなど、今でもこうしたご縁を色々といただけるのはとても嬉しいです。

このイベントの数週間前にはサンフランシスコで Databricks Data + AI Summit が開かれており、そこで発表された昨日も Databricks Japan の桑野さんから共有がありました。

developers.cyberagent.co.jp

今回の勉強会でも、やはり AI に関する話題は多かったです。Genie を使って自然言語でデータ抽出・分析できるのはもちろんですが、利用できるテーブルを制限したり、Genie を Slack から利用できるようにして利用間口を広げる取り組みなど、各社様々な取り組みがされていました。

参加者はエンジニアの方が多かったようで、PrivateLink, Terraform, DAB など IaC に関する取り組みの共有も多かったです。懇親会も多くの方が集まり、各社の悩みや取り組み、利用している技術など様々なお話をさせていただきました。

今回ありがたい機会をいただき、こうして発表することができましたが、改めて知識を整理する機会として外部登壇を定期的にするのは必要だなと感じました。また機会があれば発表できるよう、日々業務に取り組みたいと思います。

AI エージェントを使ったスライド PDF 作成方法

スライドのPDF作成に、マークダウンでスライドを作成できる VSCode のプラグイン Marp を利用したので、その話をしたいと思います。

発表資料

次の資料は、今回紹介する方法で作成したPDFです:

Marp: マークダウンからスライドを作成

今回の発表は構築したシステムに関するものだったので、Github リポジトリの実装内容をまとめながらスライドを起こしたいと思っていました。このプロジェクトでは Github Copilot を使うことが多いので、Copilot からスライドを生成できるツールはないかと探していたところ、Marp というプラグインが見つかりました:

Marp for VS Code - Visual Studio Marketplace

Marp 自体は古くからあるアプリケーションのようですが、AI を利用した開発をする要領でプレゼンテーションの準備ができるため、今の時代とも相性がよさそうです。

今回の発表ではシステムアーキテクチャを始めとして図表が多く、Marp で図表もそのまま埋め込めないかと検討しましたが、Mermaid 形式であれば対応しているようでした。

私は普段 PlantUML を使っているため、 PlantUML のレンダリングは plantuml コマンドを利用して SVG 形式にし、画像をマークダウンから参照させる方法を取ることにしました。PlantUML 自体のプレビューは VSCode で可能なので、最後に SVG 化させればよく、基本的には Copilot 経由で Marp, PlantUML どちらも生成する形式です。

良かった点

VSCode 内でスライド作成が完結する

PowerPoint や Google Slides を使う場合だと、開発コードや公式ドキュメントを往復し、図を別で作成して貼付するなどアプリケーションの切り替えが多く発生すると思います。

今回の VSCode + Marp + Copilot (AIはなんでもいい) だと、VSCode を中心としてじっくり資料作成に取り組むことができます。

テーマが変更しやすい

マークダウン形式で全て記述するため、HTMLを作っているような感覚です。実際、CSSも利用可能です。

そのため、テーマを変更する際にはスライド全体に当たる領域でテーマや各種数値を変更すればよく、最後までレイアウトの調整が可能です。

スライド分割しやすい

マークダウン中にハイフン3つ --- 記述するだけでスライドが分割されます。

分量が増えてしまったスライド、図表を入れて膨らんだスライドなどを簡単に分割することが可能です。

常に全体の流れが把握できる

マークダウン1ファイルにプレゼンテーションを全て記述するので、全体の流れが頭に入りやすいです。

また、スライドを追加していて発表の流れが噛み合わない時も、テキストベースなので簡単に構成変更でき、改善しながらスライドを作ることができます。

イマイチな点

レイアウト微調整に時間がかかる

CSS が記述できるので細かい調整はいくらでもできますが、GUI ベースで調整できる PowerPoint / Google Slides などと比べて、調整に時間がかかります。

これは Copilot が原因かもしれませんが、思うように調整されないことも多いです。技術情報の共有など、あまりスライドが複雑にならないようなユースケースに向いていると思います。

出力解像度が低い

PDF に出力する際、16:9 だと 960px : 540px となってしまいます。発表時には不便はありませんが、SpeakerDeck は横幅 1000px 以上でないと表示に不具合がでるようです。

クラスメソッドさんでは Marp のテンプレートを公開しており、そこでは 1920px : 1080px となるように自作テーマを作成されています:

GitHub - classmethod/classmethod-marp-theme: クラスメソッド社内向けMarpカスタムテーマ · GitHub

ただ私の環境ではどうやっても 960px から変更できず・・・。PlantUML の出力を PNG から SVG にして SpeakerDeck にアップロードすると、警告はでるものの許容できる圧縮率だったので、今回は画像フォーマットの変更で凌ぎました。次回挑戦時にはクラスメソッドさんのテーマを元にプレゼン作成したいと思います。

"Why Data Debt Is the Next Technical Debt You Need to Worry About / データ負債:次に警戒すべき技術的負債"

以前のブログで、"How Shadow Data Teams Are Creating Massive Data Debt" ((Shadow Data Teamsによるデータ負債の蓄積) という Medium の記事を紹介しました:

bynatures.hatenadiary.jp

medium.com

この続編が出ていたのでまとめと感想を書いてみます。

前編は Shadow Data Teams という、データチームの観点からデータ負債が生まれる原因を解説していましたが、後編はデータ負債の定義から始まり、それがどうして生じているか、どういう影響があるかをより広い視点で取り上げています。

記事を Claude の要約を元に整理しました。

Why Data Debt Is the Next Technical Debt You Need to Worry About (データ負債:次に警戒すべき技術的負債)

medium.com

データ負債とは

データ負債とは、データ資産の維持・更新・管理への投資を避けたり遅らせたりすることによって生じるコストのことです。

技術的負債と似ていますが、対象がコードではなくデータベースやデータウェアハウス、データレイクなどのデータ資産である点、そして原因が「短期目標と長期投資のトレードオフ」ではなく「データサイロの増殖、重複、不整合」である点が異なります。

なぜ今、データ負債が問題になっているのか

著者は主に5つの要因を挙げています:

  1. データ量の爆発的増加によるサイロ化
  2. データガバナンスポリシーの欠如
  3. データリテラシーや文化の不足
  4. 複数チームがそれぞれ異なるツールやプロセスでデータを扱うことによる定義の不一致(例:「顧客」の定義がチームごとに違う)
  5. 急成長やM&Aに伴う既存システムとの統合困難

現場で見られる具体例

記事ではさまざまな実例が紹介されています:

  • 誰も使っていないのに維持されているダッシュボードやテーブル
  • データサイエンティストがCI/CDやドキュメントなしで作った「スパゲッティSQLパイプライン」
  • ソフトウェアエンジニアと連携が取れずカラム名変更で重要な価格モデルが壊れる「非合意API」問題(データ契約の不在)
  • データレイクに大量に取り込まれたものの誰も意味を理解できないデータ(データモデリングの崩壊)
  • 所有者不在のデータ(データガバナンスの欠如や Shadow data team によって発生)
  • ドキュメントの欠如(熟練エンジニアの退職と共に知見が失われる)

影響

データ負債は生産性の低下とコスト増加を招きます。具体的には、市場投入までの時間が長くなる、コストが増える、見えない負債なので工数見積もりが困難になる、品質の低いデータに基づく意思決定が悪化する、責任のなすりつけ合いでチーム間の協働が損なわれる、といった影響です。

さらに、既存のデータオブジェクトを変更する際に、それに依存している他の重要なパイプラインを壊すリスクも常につきまといます。

どう管理すべきか

まず予防が重要、というのが著者の立場です。データ品質の優先、チーム間の協働、所有権の明確化、ドキュメンテーションを開発サイクルの一部にすることが鍵となります。

すでに発生してしまった負債への対応については、CFOが財務負債を扱うのと同じ発想を勧めています。つまり、すべてを一度に返済しようとせず機会費用を考えて優先順位をつけること。Chad Sanderson氏のアプローチを引用し、すべてに手を出さずROIの高いユースケースを特定し、所有権とリネージから着手し、最小単位の所有権から拡張していく、というステップを提案しています。

まとめ

データ負債は、これまでデータを純粋に技術的視点だけで扱ってきたことが原因であり、組織全体の文化・ガバナンス・協働の問題として捉え直す必要がある——というのが著者のメッセージです。

感想

データエンジニアであればよく議題に上がることが分かりやすくまとめられていましたが、記事の最後には

My objective is to generate awareness around these problems and get people to relate to my examples because they are real-life stories. 私の目的は、これらの問題について人々の認識を高め、実際の体験談である私の事例に共感してもらうことです。

とあるように、データエンジニア以外にもこの課題を認識してもらいたい意図があることが分かります。

以前書きましたが、データが負債になりうるという指摘は DMBOK でもされており、データマネジメントの領域ではデータを資産として捉えた場合の負債となる側面は以前から言及されていました:

bynatures.hatenadiary.jp

データ負債は、ソフトウェアにおける技術的負債とは違う性質がいくつかあり、その一つにライフサイクルが長い点が挙げられます。アプリケーションの稼働が終了しても(削除ライフサイクルを定義していなければ)データは残り続けます。そのため、事業の運営期間が長くなるほどにデータ負債が増えていき、負債に対応することも難しくなっていきます。

筆者の「まず予防が重要」という言葉からも、データ負債を生まないガバナンス整備、業務プロセス等が最重要であると分かります。この点はソフトウェアにおける技術的負債が主に短期目標と長期投資のトレードオフから生じるのと大きく異なる点でしょう。

しかし事業立ち上げ当初から適切なデータ管理体制を敷けるかは、データを最初に管理し始める人がどの程度データガバナンス等に気を配れるかに依存してしまう気がしています。そうならないためにも「データ負債」という概念を広く知ってもらい、データは適切に管理しないと業務効率やコストが嵩んでくるのだとデータエンジニア以外にも知ってもらう必要があるでしょう。

データエンジニア以外と会話をするとこういった事情がまだまだ理解されていないと感じることもあり、データエンジニア側から定期的に発信していく必要がありそうです。この Medium の記事はデータ負債によって引き起こされる具体的な問題が色々と取り上げられて分かりやすい記事でしたので、ぜひ参考にしてみてください。

「良い戦略、悪い戦略」を読んで

前回の記事に加え、去年読んだ「良い戦略、悪い戦略」という本を読み返しています。

前回の記事:

bynatures.hatenadiary.jp

「良い戦略、悪い戦略」:

著者は Richard P. Rumelt 氏で、書籍では事例を豊富に交えて、「悪い戦略」を提示し、では「良い戦略」とは何なのかを後半で解説しています。理論というよりはさまざまな実例を演繹的にまとめたというのが近いです。

「悪い戦略」の4つの特徴は端的にまとめられていますが、どれもみなさん経験があるはずで、それほど「悪い戦略」が身近なものだと感じます:

  1. 空疎である
  2. 重大な問題に取り組まない
  3. 目標と戦略を取り違えている
  4. 間違った戦略目標を掲げている

2の「重大な問題に取り組まない」は課題感をもっている人には切実な問題ですが、現状の業務から離れて物事を考えたり、既存業務・システムに変更が加わる場合は自分のアイデンティティ領域を壊しかねない場合もあり、前回ご紹介した「エンジニアリング組織論への招待」の言葉を引用すれば「心理的安全性が十分に高い状態でないと議論ができない」のだと思います。アリストテレスの「弁論術」ではエトス・パトス・ロゴスが説得において最重要だと説いていますが、エトス(話し手の人柄、credibility, trustworthiness)に近い話かもしれません。

Rumelt 氏は個人ブログでもいまだに戦略に関する記事を投稿し続けています。"Becoming a Strategist" シリーズは多面的に「戦略」や「戦略家」とは何かを語っていて、とても読み応えがあります:

rumelt.substack.com

open.substack.com

面白かった節を一部引用します:

Many executives and leaders dislike discussing challenges and impediments, which hinders strategic thinking. In such cases, the strategist's role is to speak truth to power, helping the executive or leader confront the competitive, technological, or managerial challenge. 多くの経営者やリーダーは、課題や障害について議論することを嫌う傾向にあり、それが戦略的思考を妨げる要因となっています。そのような状況において、戦略家に求められる役割は、「権力に対して真実を語る(Speak truth to power)」ことであり、経営者やリーダーが競争上、技術上、あるいは管理上の困難な課題に正面から向き合えるよう支援することなのです。

これもまさに2の「重大な問題に取り組まない」に当てはまる状況です。

Clayton Christensen’s The Innovator’s Dilemma is a must-read. He writes: “the logical, competent decisions of management that are critical to the success of their companies are also the reasons why they lose their positions of leadership.” Not all his background on disk drives has stood the test of time, but the basic thesis has. Firms become captive to serving their existing customers with their existing methods, resisting new, usually less profitable innovations. Apply this concept to the U.S. government if you dare. クレイトン・クリステンセンの『イノベーションのジレンマ』は必読の書です。彼はこう記しています。「企業の成功に不可欠な、経営陣による論理的で有能な意思決定こそが、まさにその企業がリーダーの地位を失う理由でもある」。ハードディスク業界に関する彼の分析背景のすべてが、時の試練に耐えられた(現代でも通用する)わけではありませんが、その基本となる命題は今も揺るいでいません。企業は、既存の手法で既存の顧客に奉仕することに囚われるあまり、新しく、そして往々にして(当初は)利益の少ない革新を拒んでしまうのです。もし勇気があるのなら、この概念をアメリカ政府に当てはめてみてください。

これはちょっと違う観点で、短期的な最適化が長期的に成果を生むとは限らない(むしろ失敗につながる)という主張です。既存の手法で既存顧客に向けた最適化をすると、新しいイノベーションをもった企業にいつか地位を奪われる・・・という感じでしょうか。

企業で働くというのは社長でない限り上位者がいるわけで(上場企業であれば社長でさえ株主がいる)、その中で現在の方針や業務を大きく変えてしまうような「重要な問題」は議論しづらいのは想像に難くありません。外部からコンサルティングという形でなら色々と提言しやすいかもしれませんが、Rumelt 氏は戦略は実行可能なもの、もしくは空から俯瞰して見れると同時に地に足のついたものであるべき、とも主張しています。これは戦略が絵に描いた餅ではなく、現実の課題を直視して練られるべきだということでしょう。外部からの提言がどこまで実行可能なのかは、その外部企業と当該企業の信頼関係も大きく影響しそうです。

プログラマとアイデンティティ

もくもく会に参加されている方から「エンジニアリング組織論への招待」という本を紹介してもらいました。タイトルから想像する内容とは良い意味で裏切ってくる、非常に面白い本です。読み物系なので通勤中に少しずつ読んでいます。

ソースコードとアイデンティティ

第3章「アジャイルなチームの原理」で、プログラマー Paul Graham 氏のブログが引用されています:

Keep Your Identity Small

宗教や政治についての議論がどうして意味のないものになってしまうのか、という書き出しから始まるのですが、1つの仮説を挙げています:

... and people can never have a fruitful argument about something that's part of their identity.

人はそのアイデンティティの一部となっていることについて実りのある議論はできない

宗教や政治だけでなく、その人がアイデンティティを持つもの(例えば愛着をもつプログラミング言語)についても同様とのことです。自分のアイデンティティが否定されることは心理的安全性を脅かすため、回避的・攻撃的な行動に繋がってしまうということのようです。

プログラミング言語だけでなく、人は自分自身が書いたソースコードにもアイデンティティを持ちがちだという話が書籍の中でされています。ソースコードレビューの難しさがたびたび話題に上がりますが、ソースコードがアイデンティティに直結しうるものだと考えると、レビューに対して不快感をもつ人がいるというのも理解できます。マサカリが飛んでくるとも言いますが、それだけレビューが攻撃的に捉えられてしまう場面が多いということでしょう。ソースコードだけでなく、人は自分で生み出したものは多かれ少なかれ愛着をもつものなのかもしれません。

アジャイルの文脈では、いくつかの不確実性を下げることで理想的な状態を目指そうとしており、その1つが人と人とのコミュニケーション齟齬や情報格差を表す「通信不確実性」です。これを減らすために少人数チームで対話を重視し、お互いのアイデンティティをなるべく傷つけないような心理的安全性の高さを保つことで、コミュニケーション断絶を避けようとしています。

AIを利用した開発から考える

この書籍は2018年に出版されたので、AIエージェントを利用した開発はなかったか、今ほど盛んではありませんでした。AIエージェントを利用した開発現場では開発効率が高まりますが、アイデンティティという観点から考えるとどうでしょうか?

以下の記事は、AIエージェントを利用した開発では、エンジニアはAIを監督する立場となり、アイデンティティの危機に瀕していると書かれています。

www.businessinsider.com

Reddit の投稿で目についたのですが、AIを利用した開発ではオーナーシップが低く感じられ、他人からのレビューを受け入れやすいという意見がされています。それは「他人が書いたプログラムだから」ではないかとシンプルなコメントもついていますが、確信をついている分かりやすい指摘だと思いました:

How much ownership do you feel towards AI generated code?
by u/hugohamelcom in ChatGPTCoding


Paul Graham 氏の著書「ハッカーと画家」第15章「デザインとリサーチ」には、プログラミングとは結果だけでなく、完成に向けて試行錯誤しやすいかも重要だと書かれています。リファクタリングやチューニングなど、いくらでもプログラムは改善することができます。筆を止めた瞬間が絵の完成だと言われるようですが、プログラミングと絵を描くことはその点で類似性があるのかもしれません:

プログラムというものは、証明のように、もともとさまざまな間違いの枝がそこいらじゅうに生えていた木の枝をきれいに刈り込んだものだ。だから言語の良さを測るには、完成したプログラムがどれだけきれいかを見るだけじゃ駄目で、プログラムが完成へと至った道筋がどれだけきれいだったかを見なければいけない。

アイデンティティに話を戻すと、アプリケーションの完成に至るまでの試行錯誤がプログラミングを通じて行われ、その中で成果物としてのプログラムにアイデンティティが宿るのでしょう。AIを利用した開発でも指示を出しているのはプログラマ自身ですが、一方で「他人が書いたプログラムだから」というコメントだったり、AIを通じて作られたプログラムにはオーナーシップが低くなるという意見からも、そこには何か決定的な違いがあるようにも感じます。

アイデンティティはどこに行ったのか

Paul Graham 氏は、物事を公平に比較するためには何事もアイデンティティを小さく保つ必要があると語っています。

AIを利用した開発では成果物へのアイデンティティが低くなる傾向がもし本当にあるのだとしたら、よりよいプログラム・アプリケーションを目指す上ではレビューや議論がしやすくなるということであり、Graham 氏の提言からすればよい兆候なのかもしれません。実際に私も、レビューを受けて実装を丸ごと捨てたりすることに最近は抵抗がほとんどなく、以前ほどプログラムに愛着をもつ場面は減ったと感じます。

今後もAIによって開発スピードが上がることにより、コードベースにはAIが書いたコードがますます増えていくでしょう。そこにアイデンティティを持ち続けるメンバーがいるとレビューでのハレーションが発生しうるため、「コードにアイデンティティを持たないこと」を前提に、チームのあり方を設計する必要があるのかもしれません。

しかし、プログラマのアイデンティティはどこに行くんでしょうか。AIに渡す設計なのか、より大きくプロダクトに責任をもち、PdM のような方向に行くのか。書いていてあまりピンときません。アイデンティティをもたないコードベースに対するレビューも本音を言えば私は辛いですが、それしかプログラミング領域の仕事が残らないのだとしたら寂しさも感じます。

AIを前提とした開発の場合、チームサイズがかなり小さくなるはずなので、チーム自体にアイデンティティをもつというのも考えられそうです。アジャイルとも相性がよさそうですし、チームビルディングやアジャイルコーチも興味があるのでチャンスがあればまたチームビルディングもしてみたいです。

宣伝:データエンジニア向けのもくもく会を実施中

毎週月曜日、19:00から私の X 上で、データエンジニア向けのもくもく会を実施しています。参加しやすいように以下の形式で実施しています:

  • 19:00 までに、私の実施ポストに返信する形で、何をするかを共有(本を読む、調べごとをする、プログラムを書くなど何でもOKです)
  • 19:00〜20:00 までは各自作業をします
  • 20:00 に X のスペースを開きますので、参加いただき、どんな作業をしたか共有します

気軽に参加いただき、データエンジニア同士の交流に使っていただけたら嬉しいです。

2025/06/23 ベトナム/マレーシア旅行

働く環境を変えることにし、有休消化で6月頭に1週間ほど海外旅行に行っていました。

久しぶりに一人で海外旅行しようと決めて、どこに行こうかしばらく悩んでいましたが、昔友人がお勧めしてくれたベトナムのダナンとホイアン、そして全く詳しくないマレーシアのクアラルンプールとマラッカに行ってみることにしました。一人だとあまり予定を詰め込まず、好きなものを見て食べて、疲れたらホテルに戻って昼寝したりして、自由気ままな1週間でした。

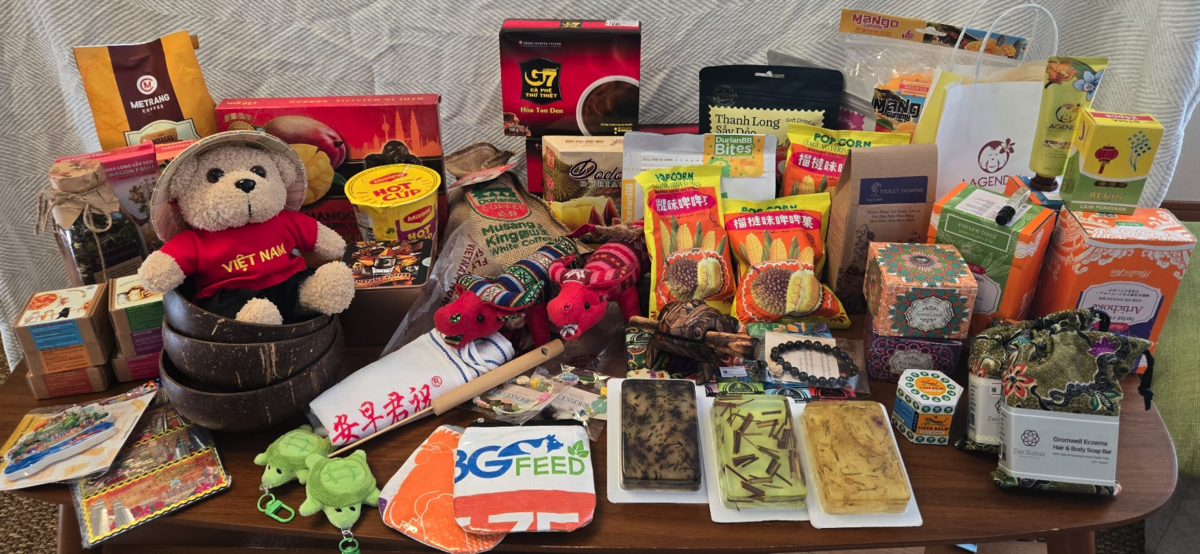
楽しくてお土産の量がすごいことに

ベトナム

ダナンのビーチ

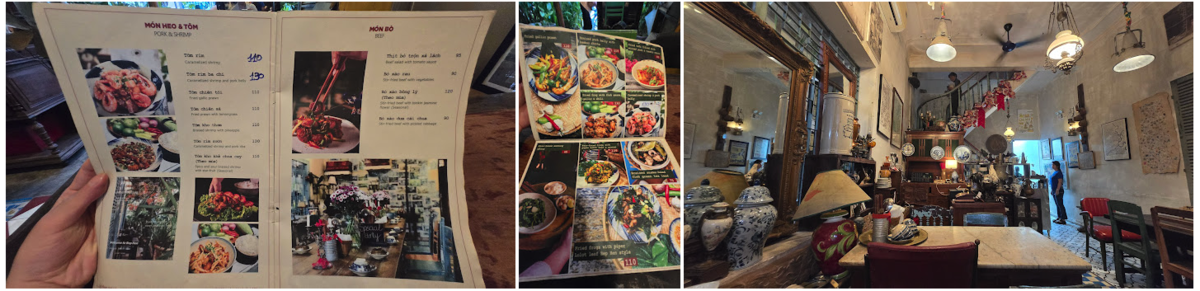
ミシュランレストラン Bep Hen

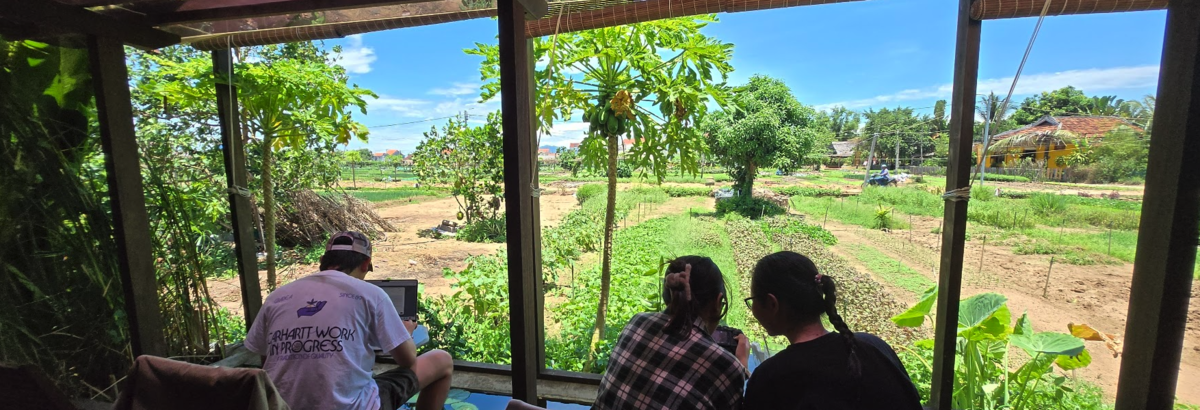
ホイアン近郊のカフェ

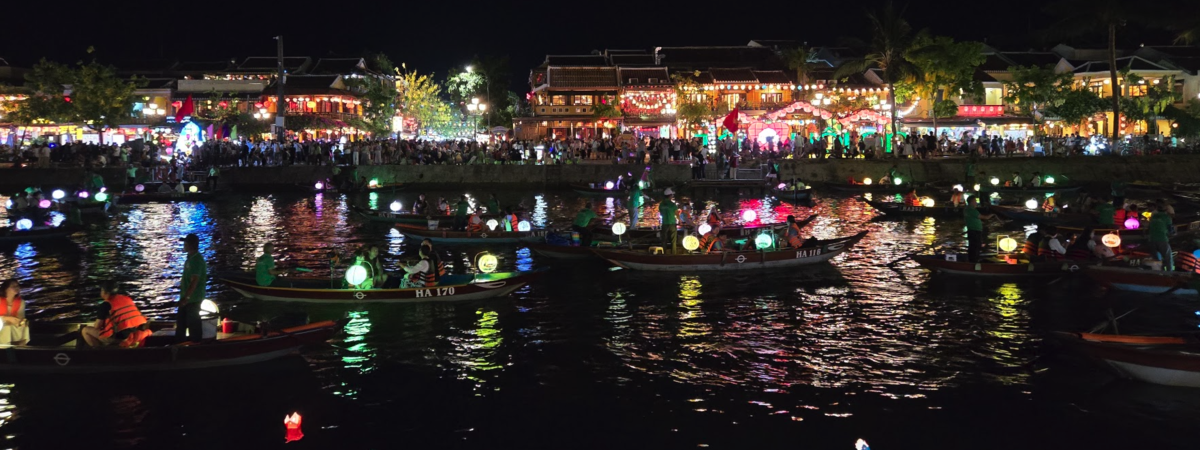
ホイアンのランタン

ダナンは(ベトナムならではの交通量の多さに目をつぶれば)ホテルの目の前が綺麗なビーチでワイキキを思わせるようなリゾートでした。ベトナムらしい屋台も多いですが、少し路地に入るとおしゃれなカフェや創作料理屋も多くて歩いているだけでも楽しかったです。日夜問わず盛り上がっていて、東南アジアらしい夜の煌びやかでド派手なネオンを見たり、ビーチでただ本を読んだりしました。ベトナムは3回目なのですが10年以上ぶりで、バイクや車のクラクションも懐かしい気持ちを味わえました。

ダナンから1時間ほどにあるホイアンという港町にも行きました。ベトナムはフォーやブンと一緒に大量のハーブを食べるのですが、そのハーブを栽培している田園エリアでご飯を食べました。ハーブの味が濃くて今回の旅行で一番美味しかったです。夜は有名なランタンを見ましたが、日本で言うと都心部の夏祭りぐらいの勢いで人がおり、これが毎夜繰り返されているのかと思うと圧倒されてしまいます。お土産屋さんの店員さんと少し話しましたが、その人はホイアン生まれでホーチミンに就職したものの、交通量の多さに耐えられずにホイアンに戻ってきたそうです。私からするとホイアンも十分すごい人と交通量ですが、ベトナム人でもホーチミンの喧騒はやかましいと思っているのだと知ることができました。

マレーシア

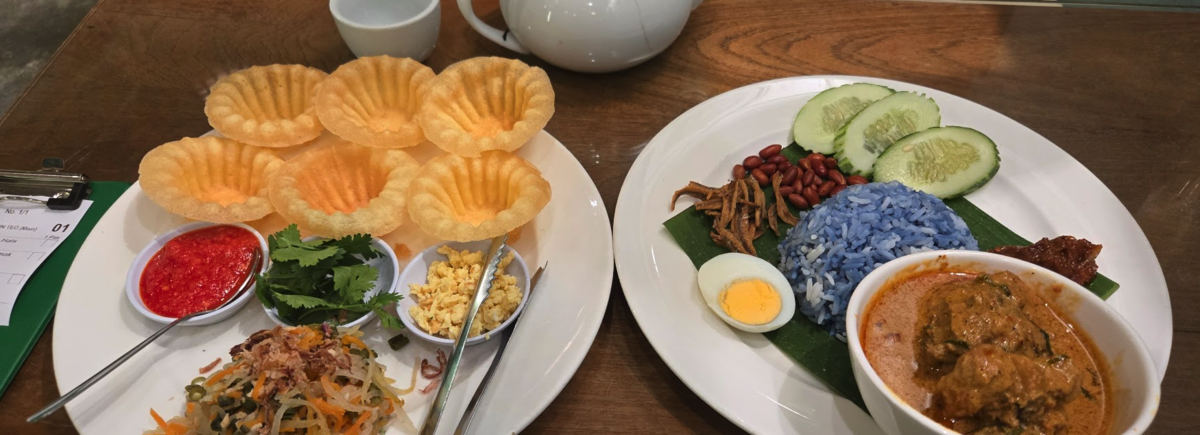
マレーシアのニョニャ料理

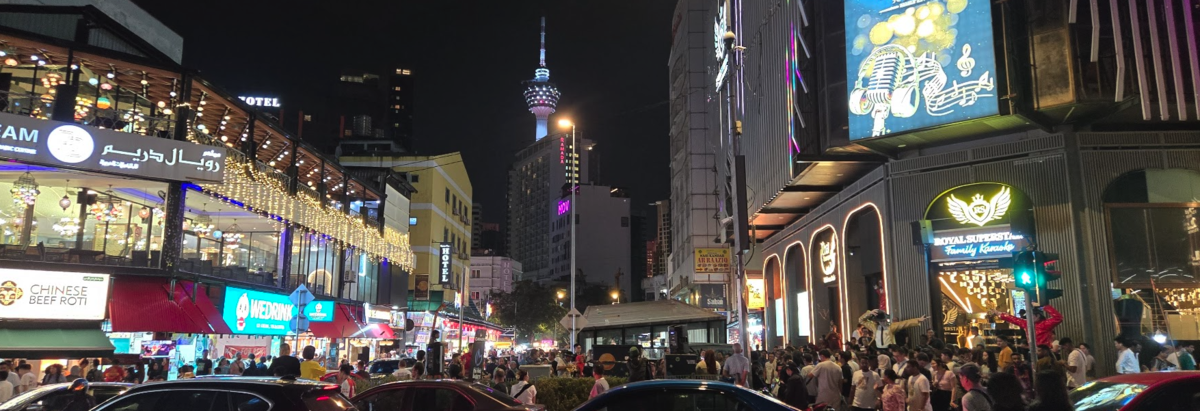
クアラルンプールのブキッビンタン

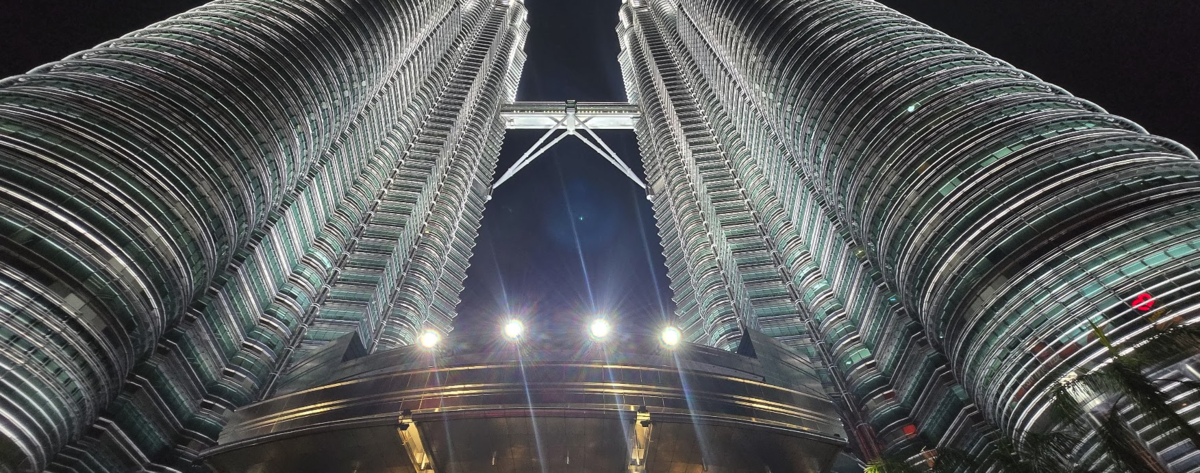
ペトロナスツインタワー

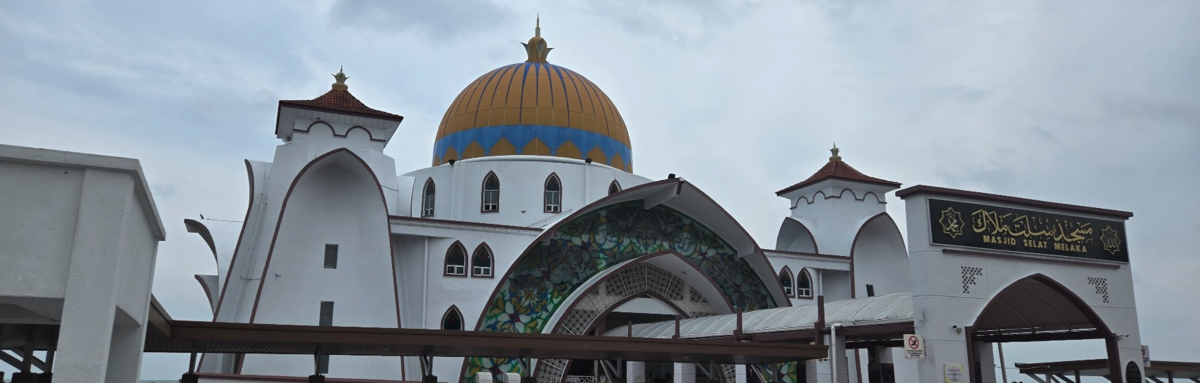
マラッカ海峡モスク

マレーシアは私にとって初めてのイスラム国家でした。タイやシンガポールに隣接していますがどちらの国とも違った雰囲気で、ムスリムがいる一方で現地中国人や旅行客の白人/中国人も多く、まさに人種の坩堝だと感じました。その人種の多さゆえかあまり厳格な雰囲気はなく、旅行中も特に危ないことにも合わず、ベトナムとおなじように観光することができました。

タクシーの運転手が色々話してくれたのですが、その人は "Local Chinese" だと言っていました。クアラルンプールで生まれた中国人で、今もクアラルンプールに住んで仕事をしているようです。もちろん個人差はありますが、一般的な中国人のイメージよりは遥かにおおらかで、中国人というよりは南国の陽気なおじさんという感じでした。中国語で話しかけたらやたら褒めてくれて嬉しかったです。最近は英語だけでなく中国語もスキマ時間に Duolingo で復習しているのですが、料理を注文したり、タクシーの運転手と簡単な会話をする程度は使えたので、数年以内に中国本土にももう一度行ってみたいなと思います。

クアラルンプールからバスで2時間行くとマラッカに着きます。マラッカも港町ですが、15世紀に存在したマラッカ王国の歴史を学んだり、その後侵略してきた西欧の文化遺産が残るなど、小さな街ですが歴史の厚みを感じられる街でした。

港町/歴史

今回の旅はベトナムもマレーシアも港町が多く、中国、西欧そして大日本帝国時代の日本の史跡を感じられました。私は歴史の授業が苦手で、テストが終わった直後に頭から抜けてしまうタイプだったのですが、実際に自分で足を運んで見聞きした街や文化を歴史を通じて学ぶのは面白さが格別でした。ダナンとクアラルンプールの歴史博物館では食い入るように説明文を読み、展示品を楽しむことができました。

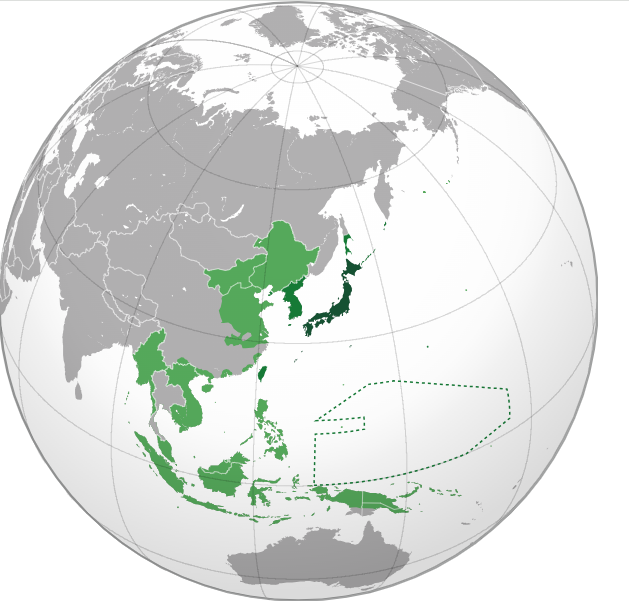
飛行機で5時間ほどでダナンにつき、そこから2時間ほどでクアラルンプールに着くのですが、大日本帝国の影響がそこまで及んでいたと考えると、当時の日本の影響力は凄まじかったのだろうと想像します。

大日本帝国による太平洋戦争中の日本軍の最大勢力範囲。大きすぎる…

ホイアンもマラッカも海上交通の要所で、ホイアンでは日本の商人が数百人規模で移住して貿易を行っていたそうです。また同じ港町マラッカでは日本の商人がフランシスコ・ザビエルと出会い、日本をぜひ訪れるべきだと進言したそうです。アジアにキリスト教を伝えた人というのはなんとなく覚えていましたが、自分の訪れた土地で数百年前にそんなやりとりがあってから実際に鹿児島に訪れたと知り、地球規模での歴史を肌身で感じることができました。

エッセンシャル思考

旅行中に一冊本を読むことが多いんですが、今回の旅行のお供は「エッセンシャル思考」でした。

現職では業務の優先度やタスク量に悩まされることが多く、Kindle に入っていたこの本が目に入って旅行中に読み耽っていました。次はこの本について記事を書きます。